El primer piloto de IA: qué probar y cómo saber si funciona
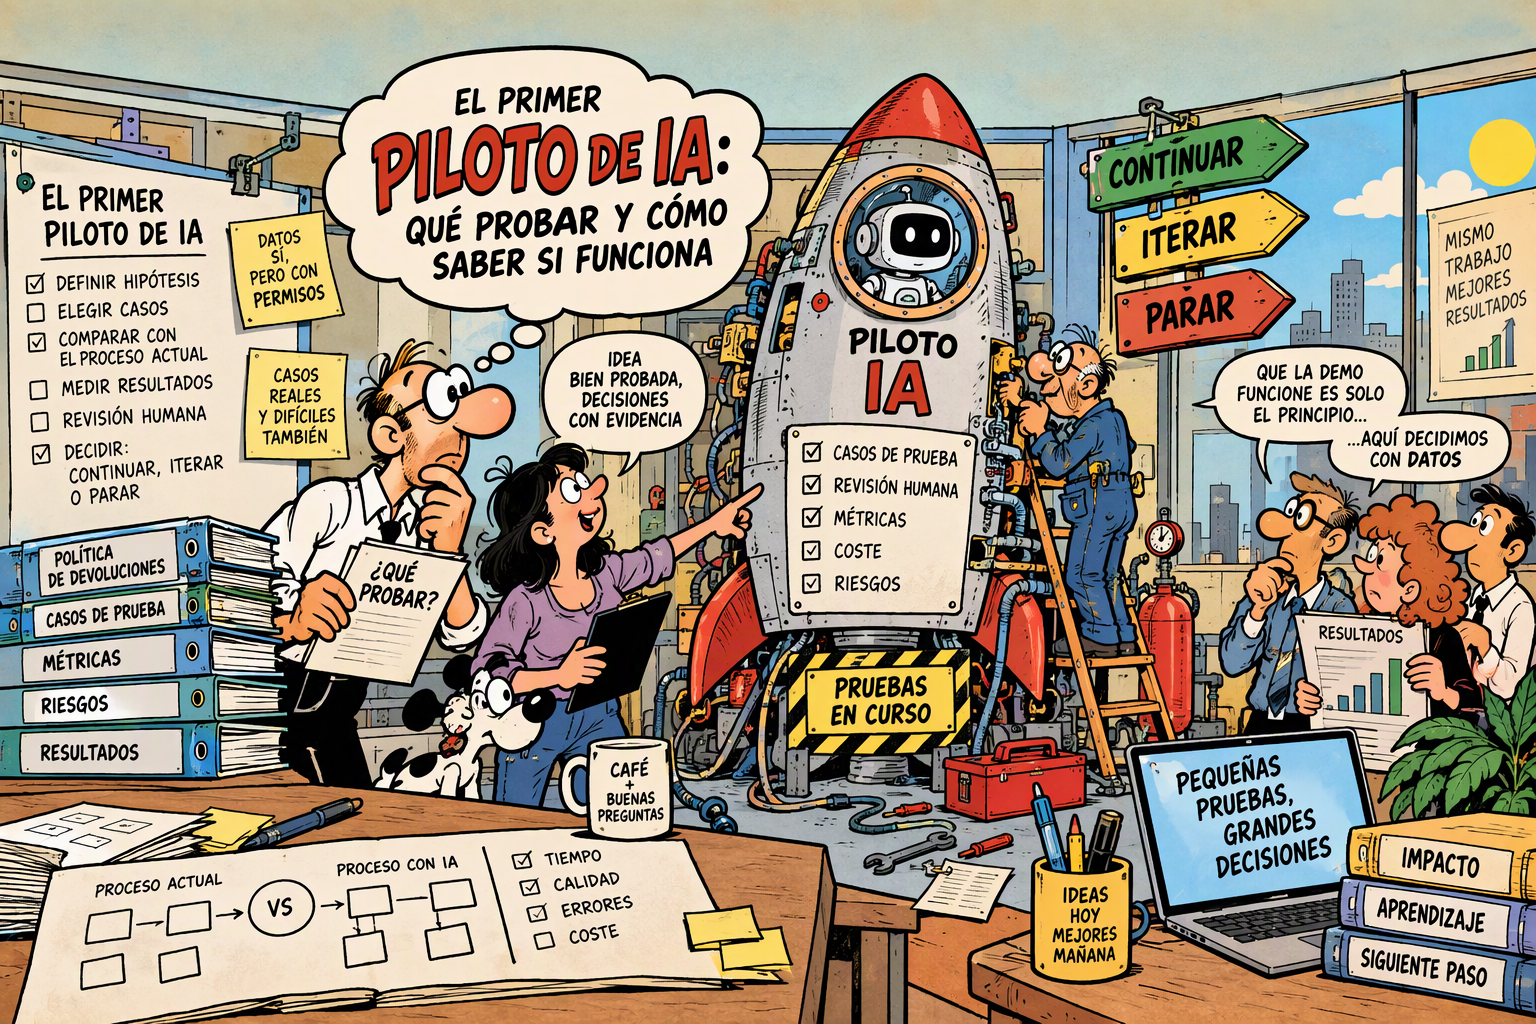
Tabla de contenido
Ya hemos elegido una oportunidad para incorporar IA en la empresa. El equipo está de acuerdo, hay ganas de empezar y alguien ha preparado una demo que responde muy bien a tres preguntas.
¿Y ahora qué?
En el artículo anterior hablábamos de comparar oportunidades antes de comprar herramientas. El siguiente paso no es desplegar la demo para toda la empresa. Es preparar una prueba que nos permita entender si esa idea mejora algo, cuánto cuesta y qué ocurre cuando deja de recibir preguntas fáciles.
Porque una demo puede enseñarnos lo que una herramienta es capaz de hacer. Un piloto debería ayudarnos a decidir si merece la pena usarla en nuestro trabajo.
Una hipótesis, no una promesa #
Sigamos con el ejemplo de la tienda en línea del artículo anterior. Su equipo de atención al cliente recibe preguntas sobre devoluciones y queremos comprobar si la IA puede ayudar a preparar las respuestas.
El ejemplo es hipotético: no son resultados de una empresa real ni una estimación de lo que ahorrará la tuya.
Para empezar, acotaría el trabajo así:
- La herramienta prepara un borrador interno usando una política de devoluciones autorizada y actualizada.
- Una persona del equipo comprueba el contenido, corrige lo necesario y decide qué respuesta enviar.
- La herramienta no consulta pedidos, no envía mensajes y no aprueba reembolsos.
La hipótesis sería: podemos reducir el tiempo necesario para responder sin empeorar la calidad ni introducir riesgos inaceptables.
Es una hipótesis bastante distinta de «vamos a automatizar las devoluciones». Y también es más fácil de poner a prueba. No necesitamos construir un agente con acceso a media empresa para descubrir si un borrador ayuda a una persona a contestar.
Antes de empezar, además, acordaría quién es responsable del piloto, qué información puede utilizarse y bajo qué condiciones se detiene. Que la herramienta sea interna no significa que podamos subirle cualquier dato de cliente. Hay que comprobar los permisos y las condiciones de uso del servicio elegido; si no tenemos autorización, usamos ejemplos ficticios o esperamos a tenerla.
¿Comparado con qué? #
Si una herramienta genera un borrador en diez segundos, lo único que sabemos es que ha generado un borrador en diez segundos. Todavía no sabemos si el equipo tarda menos en resolver la solicitud.
Para eso necesitamos una referencia: cómo se hace el trabajo hoy. La guía de Google sobre ingeniería de machine learning recomienda medir el sistema actual y considerar soluciones sencillas antes de añadir aprendizaje automático. Es una guía de ML, no una demostración de ahorro con IA generativa, pero la pregunta sigue siendo útil: ¿qué tendría que mejorar la nueva opción?
En nuestro ejemplo compararía:
- Proceso habitual: una persona consulta la política y prepara la respuesta con las herramientas que ya utiliza.
- Proceso con IA: una persona recibe el borrador, consulta lo necesario, lo corrige y prepara la respuesta final.
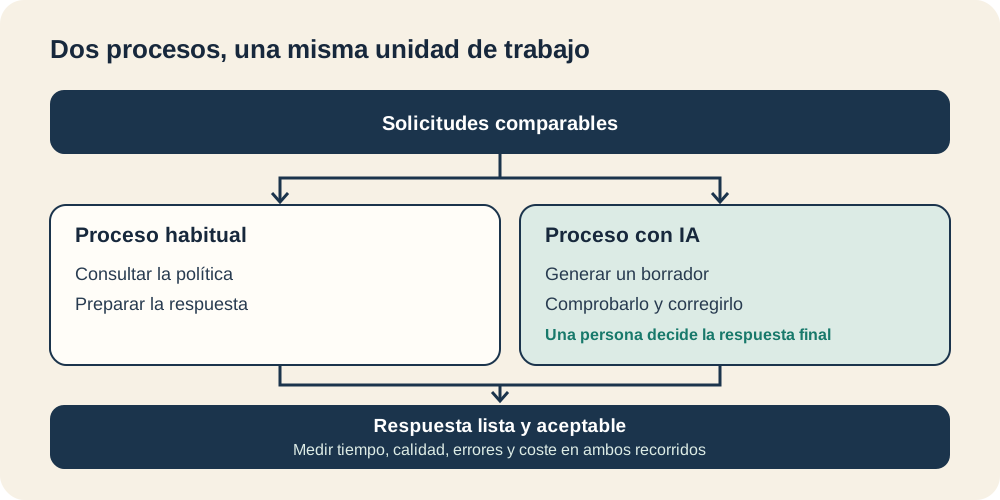
En ambos mediría la misma unidad de trabajo: una solicitud atendida hasta tener una respuesta lista y aceptable. Si se necesita una aclaración o una escalada, la registraría en vez de hacer desaparecer ese caso de la cuenta.
Para que la comparación tenga sentido, elegiría solicitudes similares en complejidad y asignaría los casos a ambos procesos de forma comparable, preferiblemente al azar cuando sea viable. También procuraría incluir distintas personas y horarios. Comparar las preguntas más fáciles del martes con IA y las excepciones del lunes sin ella nos dará números, sí, pero no necesariamente una respuesta.
Cuando sea posible, otra persona revisaría la calidad de las respuestas con criterios comunes y sin saber qué proceso preparó cada una. Si no podemos hacer esa revisión independiente o la muestra es pequeña, lo apuntamos: la comparación seguirá aportando información, pero tendrá límites.
Elegir bien los casos: lo habitual y lo incómodo #
No montaría el piloto únicamente con preguntas que ya sabemos que la herramienta contesta bien. Incluiría, por ejemplo:
- Consultas habituales cuya respuesta está claramente cubierta por la política.
- Mensajes ambiguos o con información insuficiente.
- Solicitudes en las que la política no se aplica o requiere una excepción.
- Casos en los que la respuesta correcta sea pedir más información o derivar la consulta.
El equipo que atiende estas solicitudes debería ayudar a preparar los ejemplos y a definir qué sería una respuesta aceptable. Conviene reservar casos que no se hayan usado para ajustar las instrucciones: si corregimos el sistema con todos los ejemplos y luego lo examinamos con esos mismos, nos estaremos haciendo trampas al solitario.
La guía de Microsoft para evaluar cargas de IA recomienda datos diversos y representativos, así como referencias creadas o validadas por personas. Y la función Measure del Playbook de NIST propone escoger medidas según los riesgos y documentar lo que no se ha medido. Son orientaciones, no una garantía de que una muestra concreta sea suficiente.
Aquí separaría dos preguntas. Una muestra que refleje el trabajo habitual ayuda a estimar cómo se comportaría la solución en ese trabajo. Un conjunto con muchas excepciones ayuda a buscar fallos importantes. Las dos cosas son útiles, pero si hemos añadido excepciones a propósito, el porcentaje de errores de ese conjunto no representa por sí solo la frecuencia esperada en el día a día.
¿Cuántos casos necesitamos? #
Depende de qué queramos aprender y de qué error necesitemos detectar. Google recomienda alrededor de 100 ejemplos para su servicio de evaluación y los relaciona con la calidad de las métricas agregadas y la significación estadística. No tomaría esa cifra como un mínimo universal ni como una garantía: también importan la variabilidad, la frecuencia de los fallos, el diseño y la precisión que necesitamos. La guía estadística de NIST muestra cómo el tamaño necesario depende, entre otras cosas, del cambio que se quiere detectar y de los riesgos estadísticos aceptados.
Una muestra pequeña puede servir para descubrir problemas y decidir qué investigar. No demuestra que un error grave sea imposible solo porque no haya aparecido.
Por ejemplo, si en una prueba hipotética revisamos 20 respuestas y encontramos un error grave, hemos observado un error en 20 respuestas: un 5 % en esa muestra. No sabemos que la tasa real sea exactamente esa, ni que otro conjunto no vaya a mostrar más errores. Y ese 5 % no es un umbral de aceptación recomendado: los límites hay que acordarlos para el caso concreto antes de mirar los resultados.
Medir el trabajo completo, no solo el tiempo del modelo #
La respuesta que aparece en pantalla no es todavía el resultado del proceso. Hay que leerla, comprobarla, corregirla y decidir si se puede usar. Por eso registraría, como mínimo:
| Qué medimos | Qué incluiría |
|---|---|
| Tiempo | Preparación, consulta de la política, revisión y corrección hasta tener una respuesta aceptable. |
| Calidad | Si la respuesta final es correcta, completa y comprensible según criterios acordados por el equipo. |
| Errores y excepciones | Qué ha fallado, su gravedad, si se ha detectado y cuántos casos han necesitado aclaración o escalada. |
| Coste | Uso de la herramienta y tiempo de las personas, junto con el esfuerzo atribuible de preparación e integración. |
Registraría también cuántas solicitudes se han intentado y cuántas se han completado o rechazado en cada proceso. Si solo contamos las que salieron bien, el piloto puede parecer estupendo mientras el trabajo difícil se acumula en otra parte.
Antes de la prueba, el equipo debe concretar qué significa «correcta» y qué considera un error grave. Por ejemplo, afirmar que se acepta una devolución expresamente excluida por la política podría ser grave en este caso; una frase mejorable que no cambia su significado quizá no lo sea. La clasificación y el efecto real dependen del negocio.
También podemos calcular un coste por tarea aceptada: sumar los costes atribuibles durante un periodo y dividirlos entre las tareas aceptadas en ese mismo periodo. Aplicaría el mismo criterio al proceso habitual y al piloto. Dejaría visibles los costes iniciales frente a los recurrentes y cómo se valoró el tiempo de revisión, sin sumarlo dos veces. Una cifra pequeña calculada con pocas tareas puede estar muy condicionada por el coste de preparación: no la extrapolaría sin explicar los supuestos.
La propia guía de Microsoft distingue evaluar un modelo de probar el sistema completo y aconseja no depender de una sola métrica. Tiene sentido: una respuesta rápida que luego hay que rehacer entera puede ser cualquier cosa menos una mejora.
Una persona revisa, pero ¿cómo? #
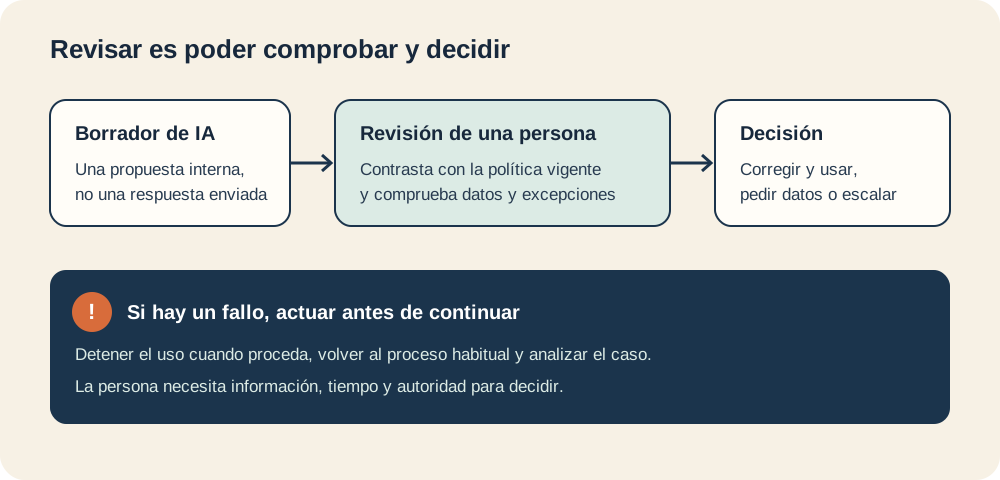
Decir «hay una persona en el circuito» no termina el diseño del piloto. Hay que concretar qué debe revisar, con qué información cuenta, cuándo debe rechazar o escalar una respuesta y si tiene tiempo y autoridad para hacerlo.
En nuestro ejemplo, quien revisa debería poder consultar la política vigente y detectar si el borrador inventa condiciones, omite una excepción o responde con seguridad cuando faltan datos. Si no puede comprobarlo, la revisión se convierte en un botón de «aceptar» con una persona detrás. Y una persona también puede equivocarse, especialmente si el texto suena convincente.
El Playbook de NIST recomienda documentar las funciones y responsabilidades de supervisión humana. Su marco es voluntario y está en revisión; no sustituye las decisiones de la empresa ni garantiza que se detecten todos los errores.
Yo dejaría registrado qué pasa ante un fallo: detener el uso cuando proceda, volver al proceso habitual y analizar el caso antes de repetir la prueba. En una tarea sensible, esa decisión no debería depender de que alguien tenga tiempo de leer un informe al final del mes.
Decidir antes de enamorarnos del resultado #
Antes de empezar, acordaría por escrito qué evidencia necesitamos y quién toma la decisión. No hace falta inventar un porcentaje universal: los límites de calidad, tiempo, coste y riesgo deben corresponder al proceso y a las consecuencias de fallar.
Al terminar, veo tres salidas razonables:
- Continuar: se cumplen los criterios acordados y hay evidencia suficiente para el alcance evaluado. Todavía queda preparar la operación; aprobar un piloto no es aprobar un despliegue masivo.
- Iterar: hemos encontrado problemas que podemos corregir sin superar los límites de riesgo. Ajustamos y volvemos a evaluar con casos reservados o nuevos.
- Parar o volver al proceso anterior: el riesgo es inaceptable, no aparece una mejora suficiente o la solución cuesta más de lo que aporta.
También puede ocurrir que la respuesta sea «todavía no sabemos». Si la muestra no permite comparar con confianza o no pudimos medir una parte importante del trabajo, toca decirlo y decidir si merece la pena ampliar la prueba. No convertiría la falta de evidencia en un aprobado por entusiasmo.
La función Manage de NIST plantea precisamente valorar si el sistema cumple su propósito y si conviene seguir con su desarrollo o despliegue. Es una decisión de negocio y de riesgo, no un marcador que se ponga verde porque la demo ha salido bien.
¿Y después del piloto? #
Si la prueba aporta valor, todavía tenemos que decidir cómo llevarla al trabajo diario: qué herramienta utilizar, qué integrar, quién la mantiene y qué ocurre cuando cambia la política o falla el servicio. Eso merece su propia conversación.
Pero si el piloto no aporta valor, tampoco hemos perdido el tiempo. Hemos aprendido algo antes de invertir más, y eso es bastante mejor que descubrirlo después de desplegar una solución que nadie necesita o nadie puede supervisar.
Para mí, el objetivo del primer piloto no es demostrar que la IA funciona. Es conseguir evidencia suficiente para decidir si funciona para esta tarea, con estas personas y bajo estas condiciones. Y tener la tranquilidad de poder decir «paramos» cuando la respuesta sea que no.
Fuentes y alcance #
- Rules of Machine Learning — Google: guía de ingeniería de ML sobre alternativas sencillas y medición inicial; no demuestra el retorno de una solución concreta de IA generativa.
- Test and evaluate AI workloads — Microsoft: guía de un proveedor sobre evaluación y pruebas de sistemas de IA, centrada principalmente en IA generativa.
- Prepare your evaluation dataset — Google Cloud: orientación para su servicio de evaluación; sus cifras no sustituyen el diseño estadístico del caso.
- Sample sizes required — NIST: ejemplo de cálculo de tamaño muestral para contrastar proporciones bajo hipótesis concretas.
- NIST AI RMF Playbook: Map, Measure y Manage: orientación voluntaria sobre contexto, medición y decisiones de riesgo; el marco está en revisión.