- The lost reference/
- Articulos/
- El modelo no trabaja solo: por qué el harness importa tanto como la IA/
El modelo no trabaja solo: por qué el harness importa tanto como la IA
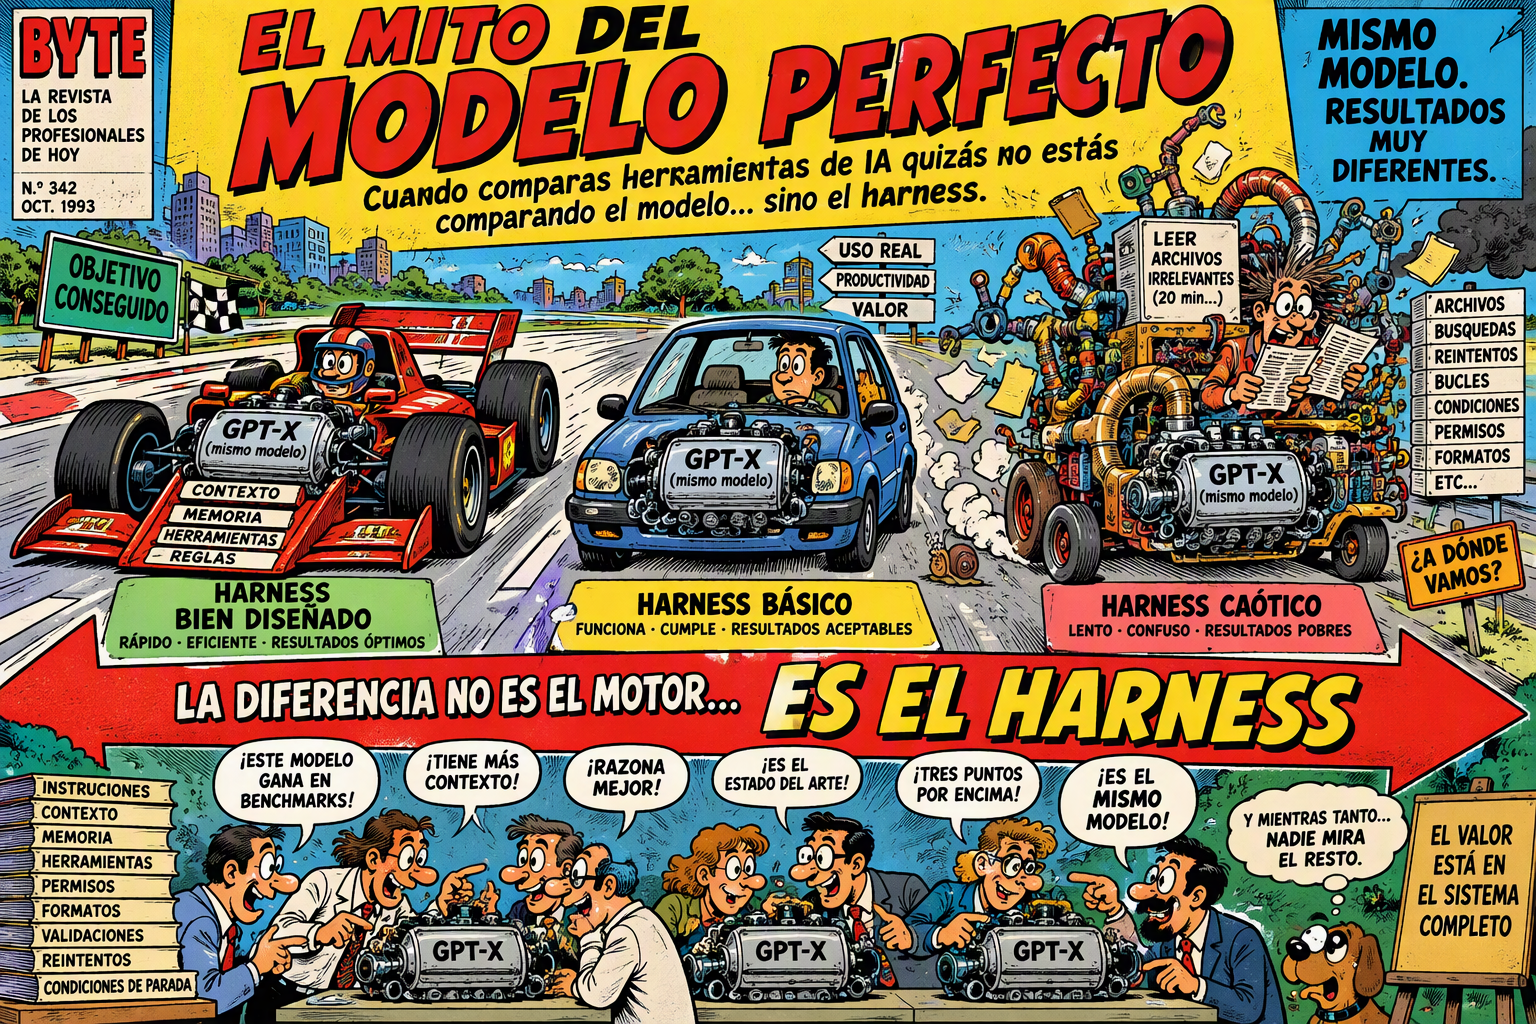
Tabla de contenido
Cuando comparamos herramientas de IA solemos empezar por el modelo. Que si este modelo razona mejor, que si aquel tiene más contexto, que si el nuevo benchmark lo coloca tres puntos por encima del anterior. Es lógico: el nombre del modelo es la parte visible, la que aparece en la documentación, en los selectores y, por supuesto, en el marketing.
Pero hay una pregunta que cada vez me parece más importante: cuando dos herramientas utilizan el mismo modelo y producen resultados muy diferentes, ¿qué estamos comparando realmente?
La respuesta corta es que no estamos usando solo un modelo. Estamos usando un sistema completo alrededor de él: instrucciones, contexto, memoria, herramientas, permisos, formatos de entrada y salida, bucles de validación, reintentos y condiciones de parada. A ese andamiaje se le suele llamar harness.
Y ese harness puede convertir un modelo competente en una herramienta muy útil o en un compañero que lleva veinte minutos leyendo archivos irrelevantes con una seguridad en sí mismo francamente admirable.
Qué es un harness de IA #
No existe una única definición cerrada del término. Según la fuente, también encontraremos expresiones como agent scaffold, agent runtime, orchestration layer o Agent-Computer Interface (ACI). Para este artículo voy a utilizar una definición operativa:
El harness es el conjunto de software, instrucciones y reglas que conecta un modelo con el contexto, las herramientas y el entorno necesarios para completar una tarea. Esta definición práctica encaja con la que ofrece la documentación de Microsoft Learn sobre Agent Harness, que lo describe como el andamiaje de ejecución que coordina el modelo, las herramientas, el contexto y el estado.
El modelo genera o selecciona la siguiente respuesta. El harness decide buena parte de lo que el modelo puede ver y hacer antes y después de esa respuesta.
En un agente de desarrollo, por ejemplo, el harness puede controlar:
- cómo se explora el repositorio;
- qué fragmentos de código entran en contexto;
- qué instrucciones recibe el modelo;
- cómo puede leer, editar o crear archivos;
- si puede ejecutar comandos y tests;
- qué ocurre cuando una herramienta falla o no devuelve nada;
- cuántas veces puede iterar;
- cómo se valida el resultado;
- y cuándo debe pedir ayuda, detenerse o entregar el trabajo.
El harness no cambia los pesos del modelo. No lo entrena ni lo hace más inteligente en sentido estricto. Lo que hace es crear las condiciones para que sus capacidades resulten más o menos aprovechables.
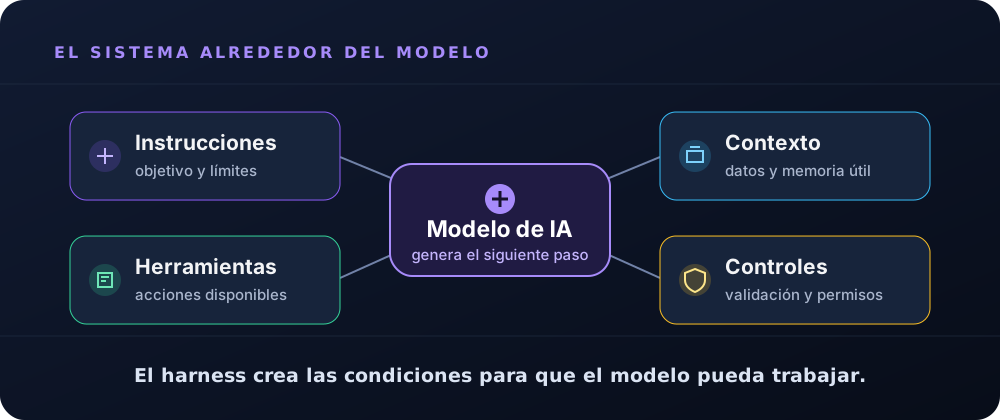
Una analogía imperfecta, pero útil, sería pensar en un motor. El modelo es el motor; el harness incluye la transmisión, la dirección, los sensores, los frenos y el salpicadero. La potencia importa, claro, pero no sirve de mucho si cada vez que giras el volante el coche abre el maletero.
Dónde vive el harness #
Una de las dudas que tenía al empezar a pensar en este tema era si el harness estaba en el modelo, en el IDE, en la aplicación o en una capa superior. La respuesta práctica es: puede haber decisiones de harness en todos esos niveles, aunque no todas pertenezcan al mismo propietario.
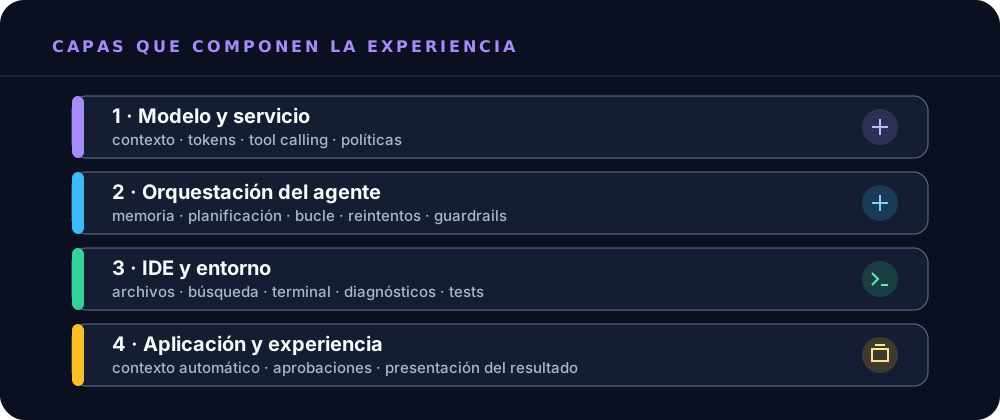
1. Modelo y servicio de inferencia #
En la capa más baja están el modelo y el runtime que lo sirve. Aquí viven aspectos como la ventana de contexto, los formatos soportados, el tool calling, el razonamiento configurable, el muestreo, los límites de tokens o algunas políticas de seguridad del proveedor.
Esta capa condiciona el harness, pero no es el harness completo. Un mismo modelo puede conectarse a agentes distintos, y un mismo agente puede cambiar de proveedor o de modelo. Frameworks como Microsoft Agent Framework hacen explícita esta separación entre el servicio de inferencia y el agente que incorpora instrucciones, historial y herramientas.
2. Orquestación del agente #
Aquí está el núcleo del harness: selección de contexto, memoria, herramientas, planificación, control del bucle, reintentos, validaciones y guardrails.
Anthropic distingue entre workflows y agentes: en los primeros, el código define una ruta predecible; en los segundos, el modelo decide dinámicamente qué pasos y herramientas utilizar. Ambos tienen harness. Lo que cambia es cuánto control se entrega al modelo.
Esto importa porque más autonomía no significa automáticamente mejores resultados. También puede significar más latencia, más coste y errores que se amplifican durante treinta pasos. La arquitectura más sofisticada no gana puntos por elegancia si resuelve peor el problema.
Las implementaciones concretas varían. Microsoft documenta un harness que combina herramientas, estado, aprobaciones y observabilidad; Anthropic explica cómo mantener el progreso entre sesiones largas; y OpenAI separa el harness del entorno donde se ejecutan comandos y se manipulan archivos. No son definiciones idénticas, pero ayudan a ver las piezas habituales y cómo se pueden distribuir.
Anthropic también cuenta que, para su agente de programación, dedicó más esfuerzo a mejorar las herramientas que a retocar el prompt general. Por ejemplo, exigir rutas absolutas evitó errores cuando el agente cambiaba de directorio. El relato aparece en su artículo sobre cómo construir agentes efectivos: el modelo era el mismo; la interfaz era mejor.
3. Integración con el IDE o el entorno #
En una herramienta de desarrollo, el IDE aporta otra parte del sistema: archivos abiertos, selección actual, diagnósticos, búsqueda semántica, terminal, referencias de símbolos, diffs y confirmaciones antes de ejecutar acciones sensibles.
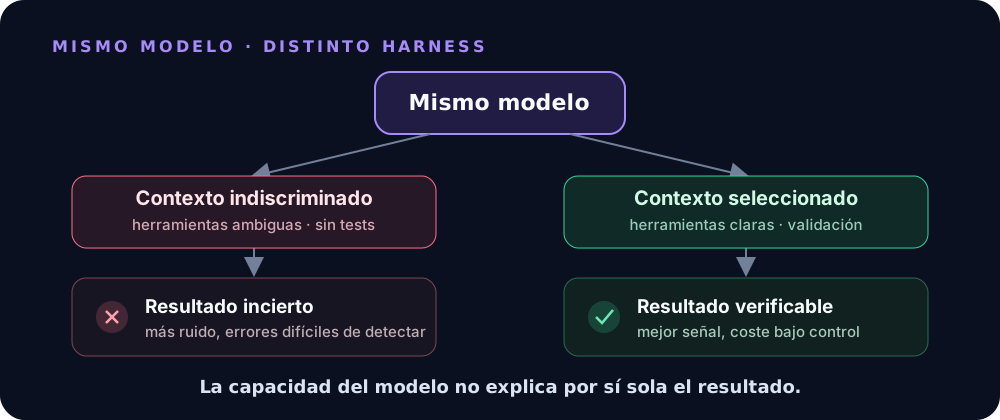
Dos asistentes con el mismo modelo pueden comportarse de forma muy distinta si uno recibe un bloque de texto plano y el otro puede localizar símbolos, leer errores del compilador, editar de forma estructurada y ejecutar el test adecuado después del cambio.
4. Aplicación y experiencia de usuario #
Por último están productos como Copilot o ChatGPT. La interfaz parece una capa superficial, pero también influye: qué contexto adjunta automáticamente, qué herramientas expone, cómo conserva la conversación, cuándo solicita aprobación y cómo presenta los resultados.
La interfaz no sustituye al harness del agente, pero forma parte del sistema que experimenta el usuario. Al final, nadie consume “pesos” directamente. Consumimos productos construidos sobre ellos.
El mismo modelo no significa el mismo resultado #
El caso más claro aparece en los agentes de programación, donde el resultado se puede verificar ejecutando tests.
En 2024, OpenAI probó el modelo exacto gpt-4o-2024-05-13 con varios scaffolds de código abierto sobre SWE-bench Verified. El mejor scaffold resolvió un 33,2 % de las tareas. En el mismo artículo, OpenAI señalaba que GPT-4 había variado históricamente entre un 2,7 % con un scaffold RAG temprano y un 28,3 % con CodeR sobre SWE-bench Lite.
Más recientemente, OpenAI describió su propia experiencia desarrollando con Codex en un entorno agent-first en su artículo sobre harness engineering. Es un caso práctico publicado por la propia compañía, no un estudio independiente; resulta útil como ejemplo de cómo el equipo organizó instrucciones, herramientas y ciclos de validación, pero sus resultados no deben leerse como una garantía de productividad para cualquier proyecto.
El modelo importaba. El sistema que lo rodeaba, evidentemente, también.
Otro ejemplo especialmente interesante es Agentless. En SWE-bench Lite, utilizando gpt-4o-2024-05-13, su proceso de localización, reparación y validación resolvió 96 de 300 tareas: un 32 %. En la tabla comparativa del estudio, SWE-agent con GPT-4o resolvió 55: un 18,33 %. Agentless reportó además un coste medio de 0,70 dólares y 78.166 tokens, frente a 2,53 dólares y 498.346 tokens para SWE-agent.
Conviene no hacer trampas con estos datos. La comparación procede de resultados recopilados por los autores y no de una única prueba controlada con idéntico presupuesto, configuración y semilla. Sirve para mostrar una diferencia relevante entre sistemas, no para atribuir causalidad perfecta a un único componente.
Las ablaciones internas del propio Agentless son más reveladoras:
- seleccionar parches solo por voto mayoritario resolvió un 25,67 % de las tareas;
- añadir tests de regresión elevó el resultado al 27 %;
- incorporar tests de reproducción generados alcanzó el 32 %;
- representar los archivos mediante un esqueleto de clases y funciones conservó mejor las ubicaciones relevantes, un 58,33 % frente a un 53,67 %, que enviar los archivos completos;
- y ese esqueleto costó 0,02 dólares de media frente a 0,15 dólares con el contenido completo.
Es decir: menos contexto, mejor seleccionado, produjo un resultado mejor y más barato. No es una invitación a recortar contexto a ciegas. Es una demostración de que el contexto debe diseñarse, no acumularse. Esto conecta directamente con Context Engineering: la información correcta importa más que la cantidad bruta de información.
SWE-agent llegó a una conclusión parecida al diseñar su Agent-Computer Interface. Sus mantenedores encontraron útil limitar la vista de archivos a 100 líneas, resumir las búsquedas por archivos y devolver un mensaje explícito cuando un comando no produce salida. El estudio de SWE-agent, publicado en NeurIPS 2024, analiza cómo el diseño de esa interfaz afecta al comportamiento y al rendimiento del agente. Mostrar más contexto por cada coincidencia confundía al modelo.
Entonces, cómo medimos un buen harness #
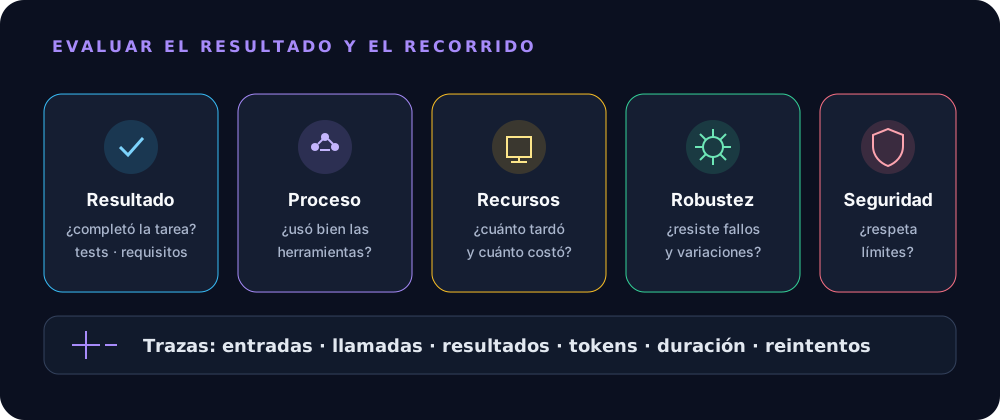
No basta con mirar si la respuesta “parece buena”. Un harness es una pieza de ingeniería y necesita una evaluación que se parezca al uso real.
Resultado de la tarea #
La métrica principal debe medir si el sistema logró el objetivo, no si dijo que lo había logrado. En código podemos ejecutar tests, compilar, comprobar el diff y revisar regresiones. En un agente de reservas hay que verificar el estado real de la reserva. En soporte, comprobar si el problema quedó resuelto.
La precisión clásica puede servir en clasificación o extracción, pero para agentes suelen ser más útiles medidas como tasa de tareas completadas, cumplimiento de requisitos, groundedness o ausencia de regresiones.
Calidad del proceso #
Dos sistemas pueden llegar al mismo resultado con recorridos muy distintos. Conviene medir:
- selección correcta de herramientas;
- exactitud de sus parámetros;
- uso correcto de los resultados;
- pasos innecesarios;
- reintentos y errores recuperados;
- intervenciones humanas requeridas.
La documentación de evaluadores de agentes de Microsoft Foundry separa precisamente la evaluación del resultado final de la evaluación del proceso y propone métricas para task completion, selección de herramientas y eficiencia de la trayectoria.
Latencia, coste y recursos #
Hay que registrar tiempo hasta el primer resultado útil, latencia total, tokens de entrada y salida, número de llamadas al modelo, coste de herramientas y consumo de infraestructura.
Un harness que mejora dos puntos la tasa de éxito multiplicando por diez el coste puede ser fantástico para una migración crítica y absurdo para autocompletar una línea. No existe una cifra buena sin un contexto de negocio.
Robustez y adaptabilidad #
La prueba debe incluir entradas ambiguas, herramientas que fallan, contexto desactualizado, repositorios grandes y variaciones de la misma tarea. Además, como la generación no es determinista, conviene repetir los casos y medir la varianza. Un 90 % de éxito medio que falla siempre en el mismo 10 % no es igual que un sistema que falla aleatoriamente una de cada diez veces.
Seguridad #
También hay que medir acciones no autorizadas, filtrado de datos, resistencia a prompt injection, respeto de permisos, capacidad de abstención y calidad de los checkpoints humanos. Dar más herramientas aumenta la capacidad, pero también el radio de impacto de cada error.
Para analizar todo esto hacen falta trazas. Entradas, salidas, llamadas y resultados de herramientas, tokens, duración, reintentos y costes permiten saber si el fallo estuvo en el modelo, el contexto, una herramienta o la orquestación. Sin observabilidad solo tenemos la sensación de que “hoy la IA está un poco tonta”, que no es exactamente una métrica operativa.
Cómo podemos influir en el harness #
Como usuarios de una aplicación comercial no controlaremos todo el sistema, pero sí podemos influir en varias capas:
- elegir el modo o agente adecuado para la tarea;
- proporcionar instrucciones estables y criterios de aceptación;
- mantener documentación, ejemplos y archivos de contexto actuales;
- exponer herramientas pequeñas, claras y con parámetros difíciles de confundir;
- limitar permisos y pedir confirmación para acciones irreversibles;
- usar tests, linters, compiladores o validadores como feedback del entorno;
- definir límites de iteraciones, tiempo y coste;
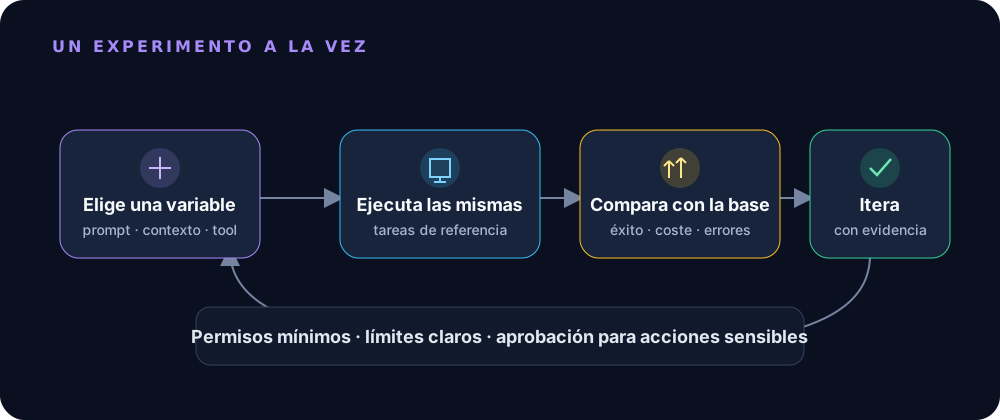
- y evaluar cambios de prompt, contexto o herramientas con el mismo conjunto de tareas.
Como desarrolladores del sistema tenemos aún más control. Podemos decidir cuándo usar una única llamada, un workflow determinista o un agente autónomo; qué información recuperar; cómo compactar el historial; qué modelo enrutar a cada tipo de tarea; y qué evidencias debe reunir el sistema antes de afirmar que ha terminado.
La recomendación más importante es bastante poco espectacular: cambiar una cosa cada vez y medirla. Si cambiamos modelo, prompt, herramientas, presupuesto de tokens y benchmark a la vez, tendremos una cifra nueva, pero no sabremos por qué.
Los benchmarks también tienen harness #
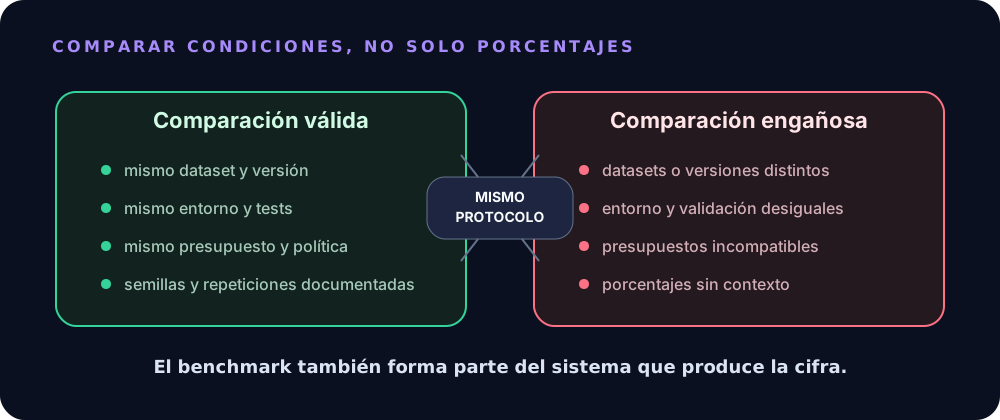
Hay una última cautela. No solo el agente tiene harness; la evaluación también. Dataset, versión, entorno, tests, presupuesto, semillas y política de ejecución forman parte del resultado.
Por eso no deberíamos comparar porcentajes de SWE-bench Lite, Verified y Pro como si fueran la misma prueba. Tampoco deberíamos leer una cifra de 2024 como una clasificación actual. De hecho, OpenAI dejó de recomendar SWE-bench Verified en febrero de 2026 para evaluar modelos frontera debido a problemas residuales en las tareas y al riesgo de contaminación de los datos, y recomienda provisionalmente SWE-bench Pro.
Esto no invalida los experimentos históricos que compararon scaffolds sobre una misma versión. Sí invalida la costumbre de trasladar sus números fuera de contexto.
Conclusión #
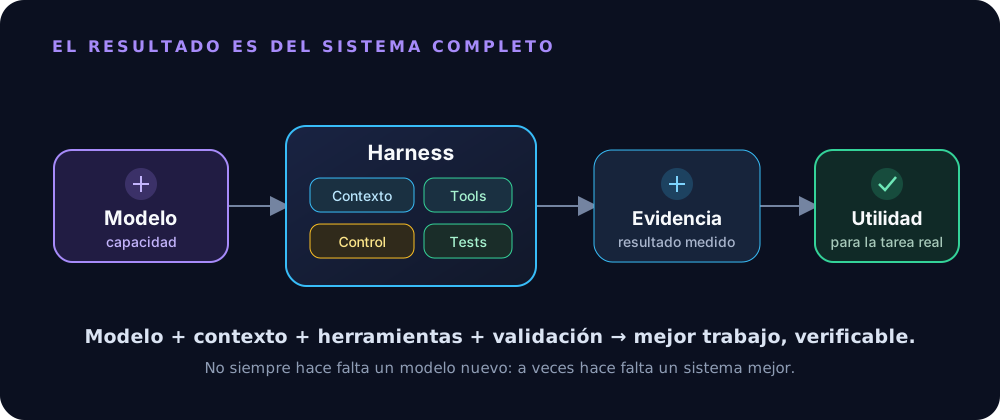
El modelo es una parte fundamental del sistema, pero no es el sistema. Entre sus pesos y el resultado que recibe el usuario hay decisiones de contexto, herramientas, memoria, control, validación e interfaz. Todo eso forma el harness y todo eso puede mejorar o empeorar el rendimiento real.
La consecuencia práctica es que elegir el modelo con mejor puntuación no basta. Hay que evaluar la combinación completa con tareas representativas, medir tanto el resultado como el recorrido y entender el coste de cada mejora.
Y quizá la conclusión más incómoda sea esta: algunas veces no necesitamos un modelo nuevo. Necesitamos dejar de poner al modelo actual delante de una montaña de contexto, darle herramientas ambiguas y sorprendernos cuando utiliza la pala para apretar un tornillo.
Fuentes: Agentless (presentado en FSE 2025), SWE-agent - estudio de NeurIPS 2024, SWE-agent - Agent-Computer Interface, OpenAI - Introducing SWE-bench Verified, OpenAI - Why SWE-bench Verified no longer measures frontier coding capabilities, OpenAI - Harness engineering, OpenAI - Agents API architecture, Anthropic - Building effective agents, Anthropic - Effective harnesses for long-running agents, Anthropic - Claude Managed Agents, Microsoft - Agent Harness, Microsoft Agent Framework, Microsoft Foundry - Agent evaluators, Microsoft Foundry - Agent tracing.
Enjoy & Happy Vibe Coding