Skills, MCP, tools y agentes: dónde poner los límites
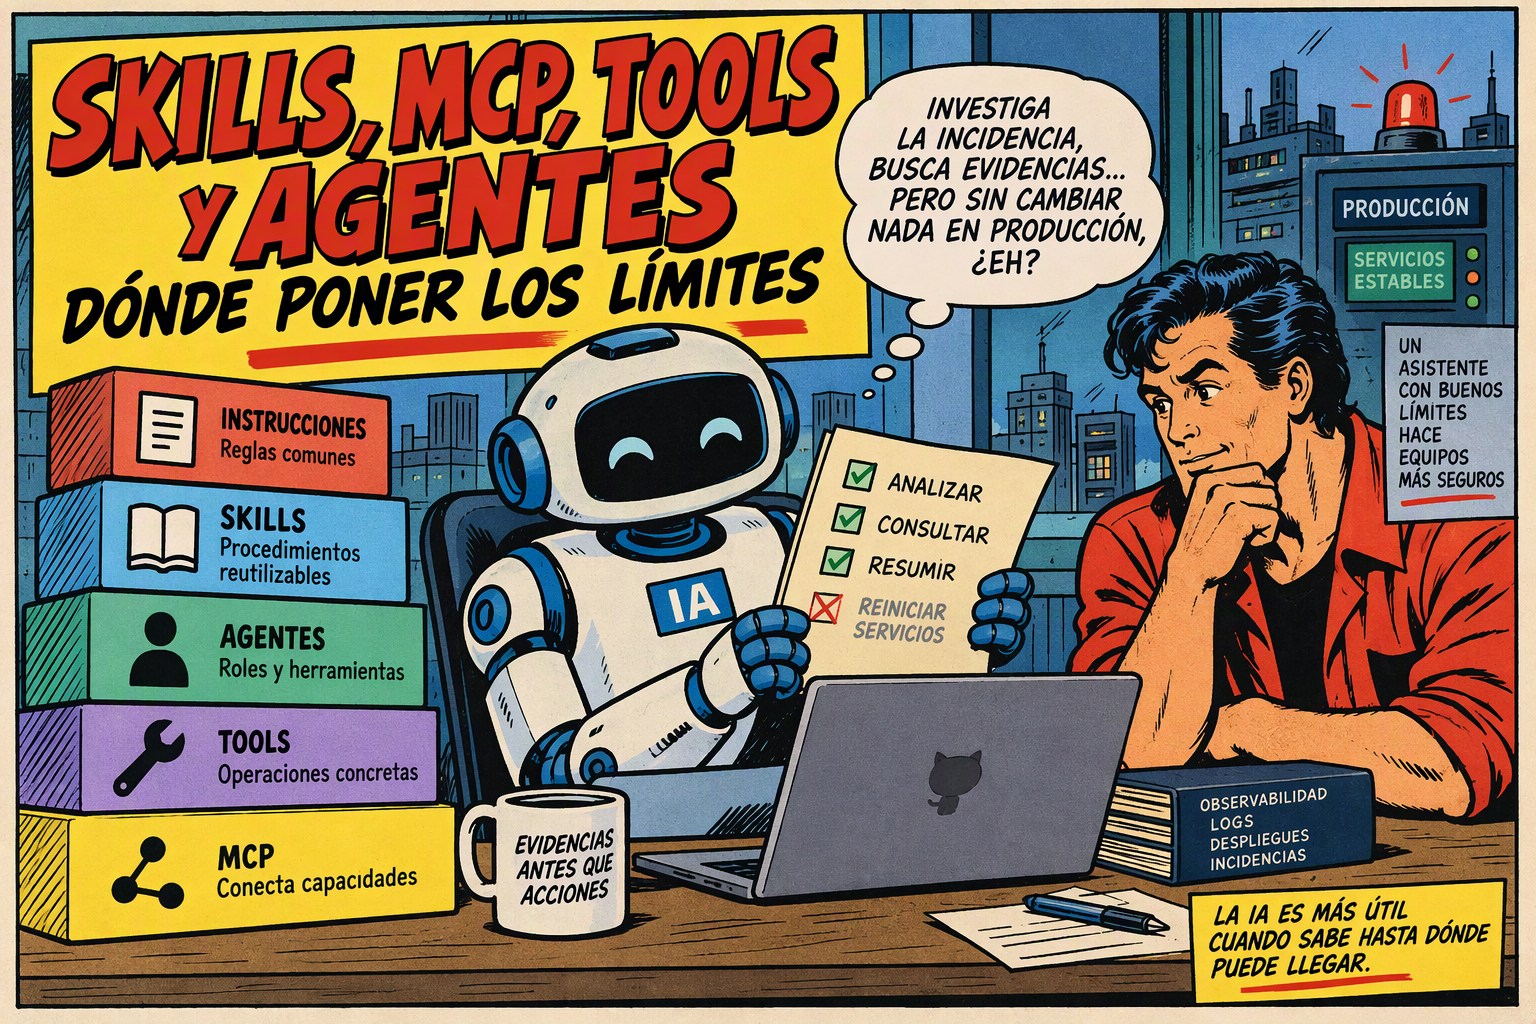
Tabla de contenido
En las últimas semanas he visto en LinkedIn comparaciones como «agentes vs. MCP», «skills vs. MCP» o «tools vs. MCP», como si fueran alternativas equivalentes. En bastantes de esos posts, me da la impresión de que se mezclan conceptos y se publica texto generado con IA sin revisarlo, lo que termina confundiendo a quien busca entenderlos.
Como diría el gran Javier Menéndez Pallo: «Ahora LinkedIn está lleno de expertos en IA; parece que das un paso y aplastas a un experto en IA». El chiste me hace gracia, aunque la confusión que señala no tanto. Estos conceptos tienen límites a veces difusos, pero algunas reglas nos ayudan a distinguirlos. Por eso escribo este artículo: tras explicar agentes, skills y subagentes, quiero mostrar cómo se combinan y dónde poner los límites.
Para aterrizarlo, pensemos en un equipo que investiga incidencias de producción: el asistente consulta registros y despliegues y resume evidencias, pero no reinicia ni cambia nada sin autorización. ¿Necesitamos una skill, un agente, una tool o un servidor MCP? Cada pieza cumple un papel distinto; lo importante es repartir las responsabilidades y no confundir instrucciones con permisos.
Cada pieza responde a una pregunta #
La documentación de VS Code sobre personalizaciones de agentes diferencia las instrucciones, que establecen pautas, de las skills, que aportan capacidades y flujos especializados que pueden cargarse cuando hacen falta; sus agentes personalizados, por su parte, combinan instrucciones y herramientas y pueden definir un modelo para un rol concreto.
Traducido a nuestro investigador de incidencias:
| Si necesitas… | Encaja mejor… | Ejemplo |
|---|---|---|
| Una petición concreta para esta ocasión | Un prompt | «Investiga el error 502 de esta mañana y resume lo que encuentres» |
| Reglas que deben orientar muchas tareas | Instrucciones | «No expongas secretos; presenta evidencias y no cambies producción» |
| Un procedimiento que se repite | Una skill | Pasos para acotar la incidencia, revisar registros y redactar el informe |
| Un rol con criterios y herramientas definidos | Un agente | «Investigador de incidencias, en modo de solo lectura» |
| Una operación que el modelo puede solicitar | Una tool | Consultar registros o listar despliegues |
| Conectar con una capacidad que aún no tenemos | MCP | Un servidor que integra el asistente con el sistema de observabilidad |
No hay que elegir una sola fila: el prompt pone en marcha la investigación, las instrucciones aportan reglas comunes y la skill evita improvisar el procedimiento, mientras el agente determina el rol y las herramientas disponibles y las tools realizan operaciones concretas.
Tool y MCP no son sinónimos #
Una tool es una acción invocable —por ejemplo, buscar_registros con un identificador de servicio y un intervalo de tiempo—, mientras que MCP es un protocolo que permite a los servidores exponer herramientas que los modelos pueden descubrir y solicitar. Dicho de otra forma, la tool realiza una operación y MCP ofrece una manera de conectarla.
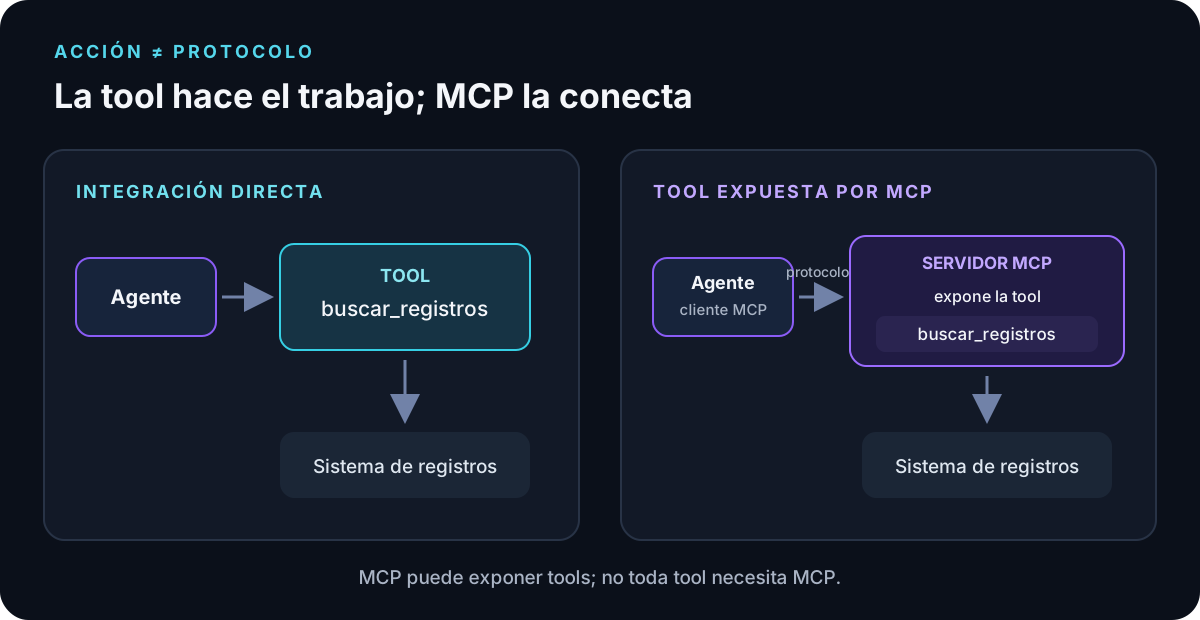
Por eso no necesitamos añadir MCP solo por llevar la etiqueta de «arquitectura de agentes»: la guía de VS Code para añadir servidores MCP recomienda hacerlo cuando el agente necesita una capacidad que sus herramientas actuales no ofrecen, de modo que, si ya tenemos lo necesario, podemos evitar incorporar otro servidor.
Si el entorno ya permite consultar los registros, añadir un servidor MCP para hacer lo mismo suma configuración y mantenimiento; si no tiene acceso a la plataforma de observabilidad, MCP puede conectar ambos. El servidor podría exponer buscar_registros y listar_despliegues, pero no sería el agente ni decidiría cómo investigar.
Dónde poner el límite de seguridad #
Podríamos escribir en las instrucciones «No reinicies servicios» o describir el agente como «de solo lectura»; ambas decisiones son útiles para orientar su comportamiento, pero ninguna le quita por sí sola el permiso para reiniciar.
Por eso, la regla que nos interesa proteger debe hacerse cumplir en la capa que ejecuta la acción —la tool, el servidor MCP, la API o la identidad que utilizan—: el agente investigador debería recibir credenciales que solo permitan leer los datos y recursos necesarios y, si más adelante incorporamos una tool para reiniciar servicios, esta no debería estar disponible para ese rol por defecto.
La especificación de MCP reconoce que las herramientas pueden actuar sobre sistemas externos y recomienda que las aplicaciones dejen claro cuáles están expuestas, indiquen cuándo se invocan y mantengan a una persona con capacidad de rechazar las llamadas; además, permite que el servidor limite las herramientas según la autorización presentada. Son recomendaciones y mecanismos del protocolo, no una garantía de que cualquier cliente o servidor los implemente como necesitamos. La guía de seguridad de MCP explica, además, que la autorización y el consentimiento deben diseñarse en la integración, en lugar de dar por hecho que MCP los resuelve.
Por eso separaría tres cosas:
- Orientación: instrucciones y skills explican cómo debería trabajar el asistente.
- Selección: el agente y el entorno delimitan qué herramientas se ofrecen para esa tarea.
- Autorización: la tool y el sistema conectado deciden qué operaciones permite realmente la identidad.
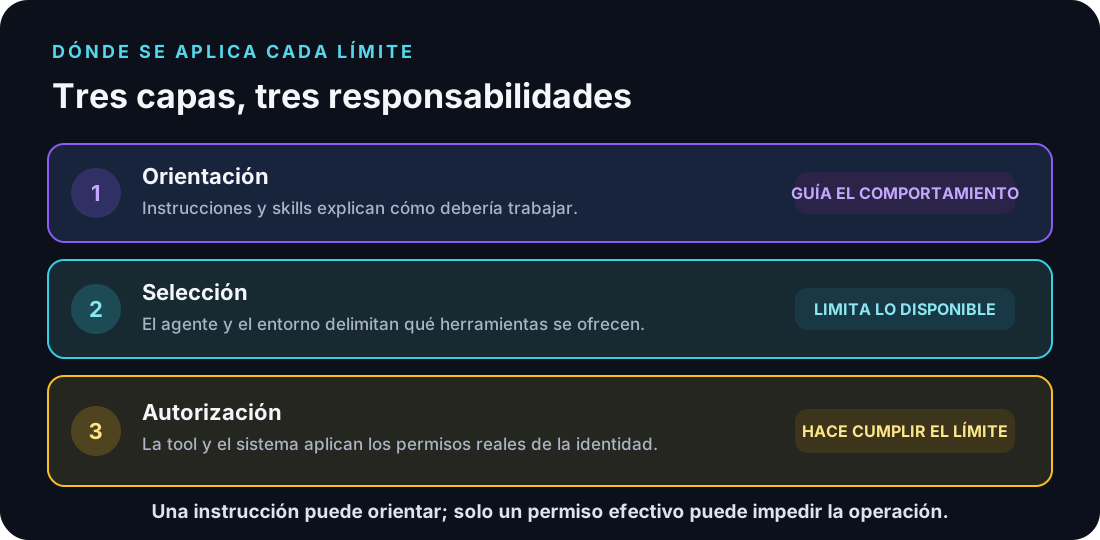
La orientación puede reducir errores y la selección, limitar la superficie de acción, pero solo la autorización debe impedir una operación que no corresponde. Si una frase en un prompt es la única barrera entre «consultar registros» y «reiniciar producción», tenemos una barrera bastante literaria.
Un diseño razonable para la investigación #
Para este caso empezaría con lo mínimo:
- Un agente investigador con herramientas de consulta, no de escritura.
- Una skill con el procedimiento de recogida de evidencias y formato del informe.
- Instrucciones del proyecto sobre datos sensibles, alcance y cómo comunicar incertidumbre.
- MCP solo si hace falta conectar con la plataforma de observabilidad y no hay ya una integración adecuada.
- Autorización de solo lectura para las consultas, aplicada también en el sistema conectado.
Si un día necesitamos automatizar una mitigación, la trataría como otra capacidad con su propio riesgo —permisos específicos, confirmación y registro—, en lugar de ampliar en silencio al investigador hasta convertirlo también en operador. Como comentaba al decidir cuándo un agente es suficiente, más autonomía solo aporta cuando resuelve una necesidad real y, en este caso, investigar y ejecutar son responsabilidades distintas.
Añade una pieza cuando resuelva un problema concreto #
Mi regla práctica es preguntarme qué nos falta —¿una instrucción estable, un procedimiento reutilizable, un rol con herramientas propias, una operación invocable o una conexión que todavía no existe?—, porque la respuesta suele señalar la pieza que conviene añadir.
Después viene otra pregunta todavía más importante: ¿dónde se hace cumplir el límite? Las instrucciones ayudan a orientar al modelo, pero las operaciones sensibles necesitan permisos reales y comprobaciones en el sistema que las ejecuta.
Para consultar unos registros no hace falta dibujar un organigrama de agentes: basta con que el asistente encuentre la información correcta, explique de dónde la ha sacado y no pueda hacer más de lo que le hemos autorizado. Lo demás puede esperar a que aparezca un problema que lo justifique.